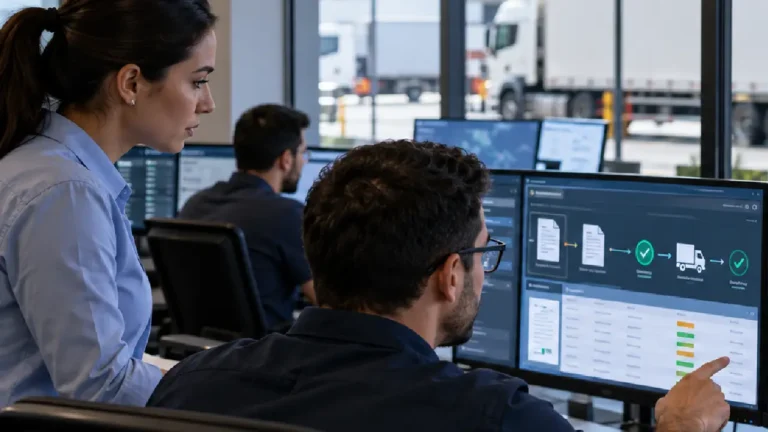
Em uma integração de sistemas, o monitoramento de APIs coleta e analisa continuamente sinais de disponibilidade, desempenho e erro para detectar problemas antes que atinjam clientes, faturamento ou operação. O objetivo é perceber degradação, latência, saturação ou comportamento anormal cedo o bastante para reagir sem transformar uma falha técnica em SLA quebrado ou pedido parado.
Resumo
- Mapeie endpoints, dependências e fluxos de negócio antes de configurar alertas.
- Combine métricas, logs e traces para enxergar sintoma, contexto e causa-raiz.
- Acompanhe latência, erros, tráfego, disponibilidade e saturação.
- Revise limiares, dependências e respostas a incidentes continuamente.
Fatos rápidos
- A OWASP API Security alerta que consumo irrestrito de recursos pode provocar negação de serviço e elevar custos de infraestrutura.
- O NIST SP 800-204A relaciona disponibilidade em microsserviços a balanceamento, circuit breaking, throttling e monitoramento contínuo da saúde dos serviços.
- O Conecta gov.br promove troca automática e segura de informações entre sistemas para reduzir a reapresentação de dados já disponíveis.
Monitoramento de APIs precisa começar pelo mapa de dependências
Monitorar somente o endpoint público cria uma falsa sensação de controle. A API pode responder e depender de banco, fila, ERP, estoque ou parceiro já degradado. O primeiro passo é inventariar endpoints, contratos, criticidade e dependências. Uma boa documentação de API transforma esse mapa em referência operacional, enquanto fluxos de integração de estoque mostram como a falha pode alcançar pedidos e expedição.
Métricas, logs e traces precisam conversar

Métrica avisa que algo saiu do padrão; log registra eventos; trace acompanha a requisição entre componentes. O OpenTelemetry descreve traces como o percurso de uma requisição, métricas como medições em runtime e logs como registros de eventos. Correlacionar esses sinais reduz o caminho entre sintoma e causa.
| KPI | O que revela | Sinal de atenção |
|---|---|---|
| Latência | Tempo de resposta | Aumento sustentado ou picos |
| Taxa de erros | Falhas por requisição | Crescimento de 4xx, 5xx ou erros de negócio |
| Tráfego/RPS | Pressão sobre a API | Volume fora do comportamento esperado |
| Disponibilidade | Capacidade de atender | Quedas, timeouts ou respostas parciais |
| Saturação | Limite de recursos | CPU, memória, conexões ou filas perto do teto |
Eu já vi uma integração entrar em pane por um loop gerado por API de terceiros. A lição é direta: autenticação e disponibilidade aparente não bastam se a arquitetura não acompanha consumo, anomalias e propagação de falhas.
Alertas bons apontam risco antes do incidente virar crise

Alertar tudo é quase o mesmo que não alertar nada. O time aprende a ignorar ruído. Os limiares precisam considerar criticidade, baseline e duração. A RFC 9110 da IETF separa 4xx como erros associados à requisição do cliente e 5xx como falhas do servidor diante de uma requisição aparentemente válida. Isso evita tratar causas diferentes como um único indicador.
Também é preciso ligar alertas a ações. Se tráfego e latência sobem juntos, há pressão na cadeia; se o RPS despenca no pico, o problema pode estar antes da API. A resposta pode exigir escalar recurso, isolar dependência ou reprocessar fila. A escalabilidade horizontal depende de sinais que indiquem onde a capacidade precisa crescer.
Confira também estes conteúdos relacionados:
- A escalabilidade horizontal mostra como distribuir carga sem perder visibilidade operacional.
- O data streaming explica como tratar eventos contínuos com baixa latência e tolerância a falhas.
- A arquitetura orientada a eventos mostra como desacoplar fluxos e reduzir propagação de falhas.
Investigar causa-raiz exige contexto, não apenas dashboard

Quando o alerta dispara, a pergunta útil é qual mudança iniciou a degradação. Compare deploys, contratos, volume e dependências. Em um fluxo industrial, um timeout entre pedido, estoque e parceiro logístico pode aparecer como falha na ponta, embora a causa esteja no meio. Sem correlação, a equipe reinicia serviços. Com contexto, corrige a origem.
Tenho defendido que observabilidade, desacoplamento e governança formam uma base mais sólida do que empilhar ferramentas. Monitorar bem, para mim, é relacionar logs, métricas, alertas e dependências a uma decisão operacional. O dashboard é superfície; agir sem derrubar o restante do ecossistema protege o negócio.
Revisar continuamente evita monitoramento obsoleto
APIs mudam, volumes crescem e parceiros alteram comportamento. Revise endpoints, SLOs, limiares, playbooks e capacidade após incidentes ou mudanças de arquitetura. Fluxos em processamento contínuo também pedem atenção a atrasos, filas e reprocessamentos. Monitoramento não é uma configuração inicial. É parte da operação da integração.
Antecipar falhas protege SLA, receita e capacidade do time
Uma API confiável não é a que nunca falha. É a que dá sinais antes, limita impacto e oferece contexto para recuperação. Mapear dependências, combinar telemetria, definir alertas e revisar o desenho transforma monitoramento de APIs em governança operacional. Se a operação ainda descobre falhas pelo cliente ou pelo pedido parado, converse com a SysMiddle para estruturar integrações com mais visibilidade e previsibilidade.
Perguntas frequentes (FAQ)
Latência, taxa de erros, tráfego ou RPS, disponibilidade e saturação formam uma base prática. A leitura precisa considerar o comportamento normal de cada endpoint e sua criticidade. Um timeout em uma API de pedidos exige prioridade diferente de uma oscilação em uma consulta secundária.
Monitoramento identifica comportamento fora do esperado por meio de métricas, logs, disponibilidade e alertas. Observabilidade correlaciona sinais e dependências para explicar por que aquilo aconteceu. Na prática, monitorar ajuda a detectar cedo; observar bem reduz o tempo necessário para localizar a causa e decidir a resposta.
Comece pela criticidade do fluxo e pelo baseline real. Defina limiares por duração, recorrência e impacto, evitando alertas para oscilações curtas. Associe cada alerta a uma ação possível e a um responsável. Se ninguém sabe o que fazer quando a notificação chega, o alerta está mal desenhado.
Mapeie a dependência, meça resposta, erros e disponibilidade separadamente e registre o impacto no fluxo completo. Use timeout, circuit breaker, retentativas controladas e filas quando o processo permitir. Assim, a falha externa deixa de ser ponto cego e passa a ser condição mensurável e isolável.
A revisão deve acompanhar mudanças relevantes de arquitetura, volume, contratos, integrações e incidentes. Endpoint novo, mudança de parceiro, crescimento de tráfego ou alteração de SLO podem tornar um limiar antigo inútil. O monitoramento precisa evoluir junto com a operação e suas dependências.