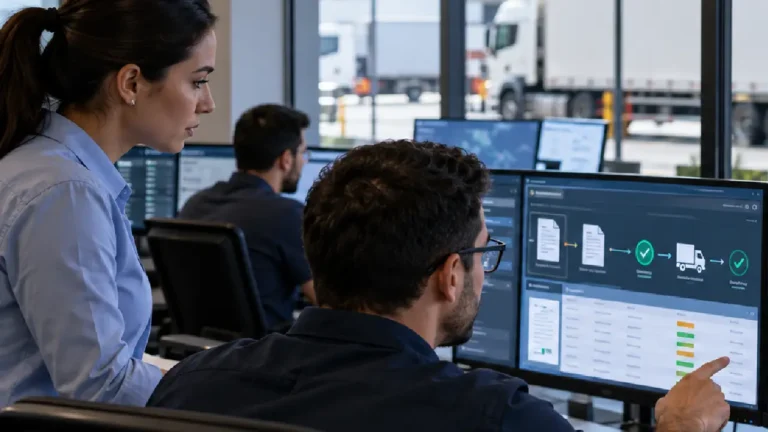
Em uma integração de sistemas, o monitoramento de integrações é o acompanhamento contínuo dos fluxos entre aplicações para identificar erros, atrasos, degradação e anomalias antes que virem pedido parado, estoque divergente ou faturamento interrompido.
Integrar e não monitorar é deixar uma parte da operação funcionando no escuro. A visibilidade precisa continuar depois do go-live, porque é em produção que volume, dependências externas, mudanças de payload e indisponibilidades começam a testar a arquitetura de verdade.
Resumo
- Mapeie primeiro as integrações que sustentam receita, operação e SLA.
- Combine logs, métricas, traces e histórico para investigar causa e impacto.
- Configure alertas por criticidade, não apenas por ocorrência técnica.
- Acompanhe erros, latência, volume, indisponibilidade e tempo de resposta.
Monitoramento de integrações começa pelo que pode parar o negócio

O primeiro erro é monitorar tudo com o mesmo peso. Uma sincronização de catálogo atrasada por alguns minutos não tem a mesma consequência de uma integração entre pedido, estoque e faturamento. Eu começaria pelo mapa dos fluxos críticos: origem, destino, dependências, frequência, volume, SLA, responsável e efeito da falha. Essa lógica conversa diretamente com uma arquitetura de integração bem desenhada, porque observabilidade sem contexto de negócio produz dashboards bonitos e pouca capacidade de decisão.
Nos projetos que acompanhei, passei a tratar uptime de integração como métrica própria, separada do uptime da aplicação. Uma conexão pode cair enquanto o sistema principal continua disponível, e o impacto só aparece depois, quando outro departamento percebe que o dado não chegou. Por isso, MTTR, disponibilidade da camada de integração, taxa de erros operacionais e custo de manutenção precisam entrar na conversa de arquitetura.
Logs isolados não explicam uma falha ponta a ponta
Registrar erro é só o começo. O OpenTelemetry explica que observabilidade combina sinais como métricas, logs e traces, e que o rastreamento distribuído ajuda a acompanhar uma requisição por múltiplos serviços. Em integrações, isso significa conseguir reconstruir o caminho de uma transação: qual pedido entrou, qual serviço processou, qual payload saiu, quanto tempo cada etapa levou e onde a execução quebrou. Sem correlação, a equipe troca diagnóstico por caça ao erro.
Esse histórico precisa conversar com status e contexto. No ERP, interessa saber se o pedido foi criado; no estoque, se a reserva ocorreu; no fiscal, se a emissão avançou; na logística, se o evento chegou ao destino. A padronização das integrações reduz a variedade de tratamentos e facilita suporte, enquanto uma plataforma como o Connect Us centraliza gestão e monitoramento do ecossistema.
Alertas precisam indicar prioridade, não multiplicar ruído
Alerta útil responde duas perguntas: o que aconteceu e quem precisa agir agora. O NIST SP 800-137 associa monitoramento contínuo à visibilidade necessária para responder a riscos em tempo adequado quando as observações indicam problemas. Na prática, uma integração crítica pode alertar na primeira falha relevante; outra pode exigir repetição, degradação sustentada ou acúmulo de fila antes de escalar. Alertar tudo da mesma forma transforma observabilidade em barulho.
| Indicador | O que revela | Decisão operacional |
|---|---|---|
| Taxa de erros | Frequência de execuções malsucedidas | Priorizar causa recorrente |
| Latência | Degradação antes da indisponibilidade | Revisar gargalo ou dependência |
| Volume | Queda ou pico fora do padrão | Investigar origem, fila ou capacidade |
| Indisponibilidade | Tempo em que o fluxo não opera | Acionar contingência |
| Tempo de resposta | Velocidade do time diante do incidente | Rever alerta, ownership e runbook |
A RFC 9110 classifica respostas 5xx como erros do servidor e define o 504 quando um gateway ou proxy não recebe resposta em tempo adequado do servidor upstream. O código ajuda a localizar o sintoma, mas não explica sozinho o impacto. O alerta precisa carregar integração, ambiente, horário, correlação da transação e dependência afetada para reduzir o tempo entre detecção e ação.
Automatizar a resposta reduz o custo do incidente

Nem toda falha exige uma pessoa apertando um botão. Retentativa com backoff, fila de mensagens não processadas, reprocessamento idempotente e circuit breaker podem resolver parte dos incidentes sem intervenção manual. O cuidado é não automatizar cegamente: repetir uma operação financeira sem idempotência pode criar um problema maior. O desenho precisa separar falha transitória, erro de regra, dado inválido e indisponibilidade externa.
Eu aprendi isso de forma particularmente dura quando uma integração que desenvolvi derrubou o sistema de faturamento de um cliente em 2014. A reversão levou horas e expôs um problema anterior ao código: levantamento insuficiente e falta de critérios claros. Monitorar bem não corrige uma arquitetura mal levantada, mas reduz muito o tempo entre o erro aparecer e a equipe entender o que está acontecendo.
Confira também estes conteúdos relacionados:
- Saiba identificar falhas com monitoramento de APIs antes que elas afetem clientes e faturamento.
- Entenda como API-led connectivity reduz conexões ponto a ponto e amplia reutilização.
- Estruture a arquitetura de integração com padrões, responsabilidades e rastreabilidade.
Monitoramento de integrações transforma falha invisível em evento tratável
Uma operação madura não espera o cliente avisar que o pedido sumiu. Ela conhece os fluxos críticos, registra cada execução, correlaciona sinais, mede comportamento, alerta pela criticidade e mantém respostas preparadas para incidentes previsíveis. Esse é o ponto em que monitoramento de integrações deixa de ser tarefa de suporte e vira capacidade operacional. Se a sua equipe ainda depende de conferência manual, quatro telas abertas e uma pessoa específica para descobrir onde o fluxo parou, vale conversar com a SysMiddle sobre uma estrutura mais previsível.
Perguntas frequentes (FAQ)
Monitore disponibilidade, taxa de erros, latência, volume de execuções, filas, retentativas e tempo de recuperação. Esses sinais precisam ser relacionados ao fluxo de negócio. Um erro no envio de catálogo pode tolerar atraso; uma falha entre pedido e faturamento pode exigir resposta imediata. A criticidade define o nível de observação e alerta.
Monitoramento acompanha condições e indicadores previamente definidos, como disponibilidade, erros e latência. Observabilidade amplia a capacidade de investigação ao correlacionar métricas, logs, traces e contexto da execução. Em integrações complexas, a diferença prática aparece quando o time precisa sair do alerta e chegar rapidamente à causa do incidente.
Classifique integrações por impacto e configure limites diferentes para cada classe. Uma falha isolada pode apenas gerar registro; repetição, aumento de latência ou indisponibilidade de um fluxo financeiro pode exigir escalonamento. O objetivo é fazer o alerta representar risco operacional real, evitando que a equipe passe a ignorar notificações por excesso de ruído.
Comece pelos fluxos ligados a receita, experiência do cliente, produção, estoque, faturamento, obrigações fiscais e logística. Depois avalie volume, dependências, SLA e dificuldade de recuperação. A prioridade não deve seguir apenas complexidade técnica. Uma integração simples pode ser mais sensível para o negócio do que um fluxo sofisticado de baixo impacto.
Automatize quando a falha for conhecida, reversível e segura para repetição. Retentativas, reprocessamento e acionamento de contingência funcionam melhor quando existem idempotência, limites e registro de cada tentativa. Erros de regra de negócio, dados inválidos ou transações com risco de duplicidade pedem tratamento mais cuidadoso e, muitas vezes, decisão humana.